综合成绩总览
OverviewClaude Mythos Preview 与第二名模型的对比。
软件工程:SWE-bench 系列
Coding衡量 AI 解决真实软件工程问题的能力。题目来自开源代码仓库的真实 Bug,模型需生成可通过测试的代码补丁。
Mythos Preview 在所有四个变体上均大幅领先前代模型。去除疑似记忆题后,领先幅度最多仅收窄 3.5 pp,排名不变。
终端操作:Terminal-Bench 2.0
Agentic由斯坦福大学和 Laude Institute 开发,测试 AI 在终端与命令行环境中完成真实任务的能力,涵盖 89 种系统操作场景,每任务运行在独立 Kubernetes 容器中,对推理速度敏感。
使用 2.1 补丁并放宽至 4 小时超时后,Mythos Preview 从 82% 跃升至 92.1%,与 GPT-5.4(75.3%)差距进一步扩大。
科学推理:GPQA Diamond
Reasoning"Google 防作弊"研究生级别科学选择题,198 道,涵盖物理、化学、生物等领域。领域专家能答对,但非专家即便借助搜索引擎也很难作答。
四款顶级模型成绩高度接近(差距 ≤ 3.2 pp),说明 GPQA Diamond 对当前最强模型的区分度趋于饱和。
多语言知识:MMMLU
Knowledge跨 57 个学科、14 种非英语语言的综合知识与推理测试,检验模型在英语以外语言中的知识广度和推理一致性。
数学证明:USAMO 2026
Math美国最顶级的高中数学竞赛,6 道开放性证明题。考试于 2026年3月21–22日举行(模型训练截止日之后),排除数据污染。由三个前沿模型组成评审团,取最低分为最终成绩。
差距最悬殊的一项:Opus 4.6 仅得 42.3%,Mythos Preview 达 97.6%,数学推理能力出现代际跳跃。Gemini 3.1 Pro 独立确认了 58/60 道题的评分。
长上下文推理:GraphWalks
Long Context测试模型在超长上下文(256K–1M tokens)下的多跳推理能力。上下文填充有向图,模型需执行广度优先搜索(BFS)或找出父节点,纯靠推理无任何捷径。
BFS 任务上 Mythos Preview 是 Opus 4.6 的两倍多、GPT-5.4 的近四倍。此项结果无法通过公开 API 复现(超出 1M token 限制)。
智能体搜索:Humanity's Last Exam
HLE2500 道覆盖人类知识边界的多模态题目,号称"最难的 AI 基准"。分纯推理(无工具)与智能体(配备网搜、代码执行等工具)两种模式。
配备工具后成绩提升约 8 pp,Mythos Preview 在有工具模式下与竞争对手的差距更为明显,说明其更善于协调工具使用与推理。
深度信息检索:BrowseComp
Search测试智能体在开放网络中定位"极难找到的信息"的能力,考查多轮搜索、网页抓取与推理的综合协调能力,而非知识储备。
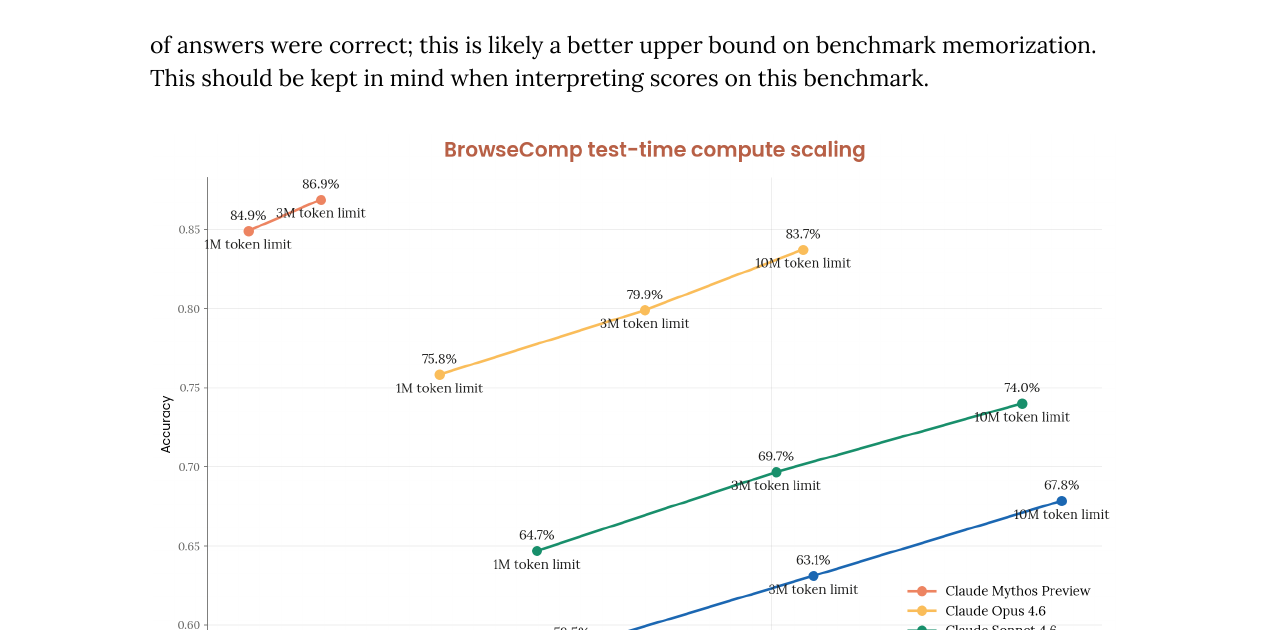
Figure 6.10.2.A — 准确率随 Token 预算增加而单调提升。Mythos Preview 用 226K tokens(Opus 4.6 的 1/4.9)达到更高准确率。
多模态:LAB-Bench FigQA
Multimodal由 FutureHouse 开发,测试模型能否正确解读生物学研究论文中的复杂科学图表,属于 LAB-Bench 系列,评估 AI 辅助真实科研的能力。
Mythos Preview 无工具成绩(79.7%)已超越专家人类基线(77.0%),配备 Python 图像处理工具后进一步跃升至 89.0%。
多模态:ScreenSpot-Pro
GUI由新加坡国立大学开发,测试模型能否在专业桌面软件高分辨率截图中精准定位界面元素,涵盖 23 种专业应用,目标元素平均占屏幕面积不到 0.1%。
配备 Python 工具后成绩从 79.5% 跃升至 92.8%,图像处理能力对高精度 GUI 定位至关重要。
多模态:CharXiv Reasoning
Multimodal来自 8 大科学领域 arXiv 论文的 2323 张真实图表,测试模型能否综合视觉信息进行多步推理,是最贴近真实科研阅读场景的多模态推理评测。
Mythos Preview 无工具(86.1%)比 Opus 4.6 有工具(78.9%)还高出 7.2 pp,代差极为明显。
电脑自动化:OSWorld
Computer Use让智能体在真实 Ubuntu 虚拟机中,通过鼠标和键盘完成实际电脑任务:编辑文档、浏览网页、管理文件。以 1080p 分辨率运行,每任务最多 100 步操作。
数据说明
· 所有 Mythos Preview 成绩:adaptive thinking,max effort,默认采样设置,5次独立试验均值
· 竞争对手数据来自各自官方 System Card 或 benchmark 排行榜
· Terminal-Bench 2.0 中 OpenAI 使用了专属 harness,与其他模型对比仅供参考
· GraphWalks 结果无法通过公开 API 复现(超出 1M token 限制)
· "—" 表示该模型未在该项目上报告成绩